


프로젝트 개요
Hex는 같은 색의 돌을 이어 자신이 맡은 서로 마주 보는 두 변을 연결하는 보드게임입니다. 이 프로젝트는 현재 보드와 자신의 차례, 남은 계산 시간을 입력받아 다음에 돌을 놓을 칸을 선택하는 CPU 기반 탐색 에이전트입니다. 가능한 수를 두었을 때의 경기를 반복해서 가상으로 진행하고, 그 결과로 유망한 수에 계산을 집중하는 몬테카를로 트리 탐색(MCTS)을 사용합니다. 실행 중 탐색하며 학습된 신경망과 GPU를 사용하지 않습니다.
탐색 정책에는 RAVE 통계와 톰슨 샘플링을 결합했습니다. RAVE는 가상 경기의 뒤쪽에서 둔 수의 결과도 앞쪽 후보의 가치 추정에 활용하는 방식입니다. 이때 탐색 경로와 가상 경기에서 같은 플레이어가 이후에 둔 수의 결과를 모으는 통계를 AMAF라고 부릅니다. 톰슨 샘플링은 추정 승률이 높은 수를 선호하면서, 아직 결과가 불확실한 수도 확률적으로 탐색하는 선택 방식입니다. 여기에 즉시 이기는 수나 상대의 승리를 막는 수를 먼저 확인하는 Hex 전술 규칙을 더했습니다.
설계의 핵심은 탐색 통계가 의도한 의미로 계산되는지 확인하면서 제한된 시간 안에 유효한 수를 선택하는 것이었습니다. Python에서 네 가지 선택 정책을 구현하고 보드 표현, 승리 판정과 루트 병렬 탐색을 C++로 옮겼습니다. 루트 병렬 탐색은 여러 실행 단위인 워커가 현재 보드에서 각자 탐색한 뒤 결과를 합치는 구조입니다. 정책과 통계 갱신 방식은 별도로 작성한 참조 계산과 대조하고, 대국 성능은 동일한 경기 시간과 탐색 횟수라는 서로 다른 조건에서 비교했습니다.
맨체스터대학교 COMP34111 AI & Games 과목의 Group 026 팀 프로젝트입니다. 제 기여는 네 가지 Python 변형의 구현과 비교, Hex 휴리스틱, C++ 이전과 루트 병렬화입니다. 제공된 심판과 팀의 공통 프레임워크는 공동 작업물로 명시하며 제출본과 경기 기록도 보존합니다.
핵심 결과
아래에서 경기 완료 수는 정해진 절차로 대국을 끝낸 횟수이고, 승률은 특정 비교 상대에게 이긴 비율입니다. 실행 실패가 없다는 결과와 상대보다 잘 둔다는 결과를 구분했습니다. 탐색에 쓰는 난수 시드는 무작위 선택의 생성 순서를 정하는 시작값으로, 같은 조건의 반복과 비교를 위해 기록했습니다.
- 같은 경기 예산의 평가
- 400 / 400
- 참가자별 상한 300초, 실행 실패 0건
- C++ 기준 구현과의 비교
- 81.0%
- 완료한 100경기 중 81승, 실행 조건을 맞춘 어댑터
- 연결성 판정 검사
- 19,683개
- 3×3 보드의 모든 색상 배치를 독립 BFS와 비교
- 전술 기능의 개별 진단
- 400 / 400
- 기능별 100경기, 수당 전체 탐색 16,000회
참가자마다 실제 응답 시간을 누적해 300초로 제한한 평가는 주어진 시간 안의 경기력을, 매 수의 전체 탐색 횟수를 16,000회로 맞춘 평가는 같은 탐색량의 정책 차이를 확인합니다. 여기서 예산은 사용할 수 있는 시간이나 탐색 횟수의 상한입니다. 평가에는 개발 조건에서 선정한 RAVE-TS와 브리지 방어, 수 정렬 및 rave_k=1000 설정을 사용했습니다. 브리지 방어는 두 빈칸을 통해 이어질 수 있는 돌의 연결을 지키는 규칙이고, 수 정렬은 유망한 후보를 먼저 살피는 순서입니다. rave_k는 직접 탐색한 통계에 비해 RAVE 통계를 얼마나 반영할지 조절하는 값입니다.
연결성 판정 검사는 돌들이 목표 변을 실제로 잇는지 확인합니다. 비교에 사용한 BFS는 인접한 칸을 차례로 찾아 연결 경로를 검사하는 별도 알고리즘입니다. 전술 기능 진단은 한 기능을 끈 에이전트와 비교해 그 기능이 결과와 응답 시간에 미친 영향을 살펴보는 실험입니다.
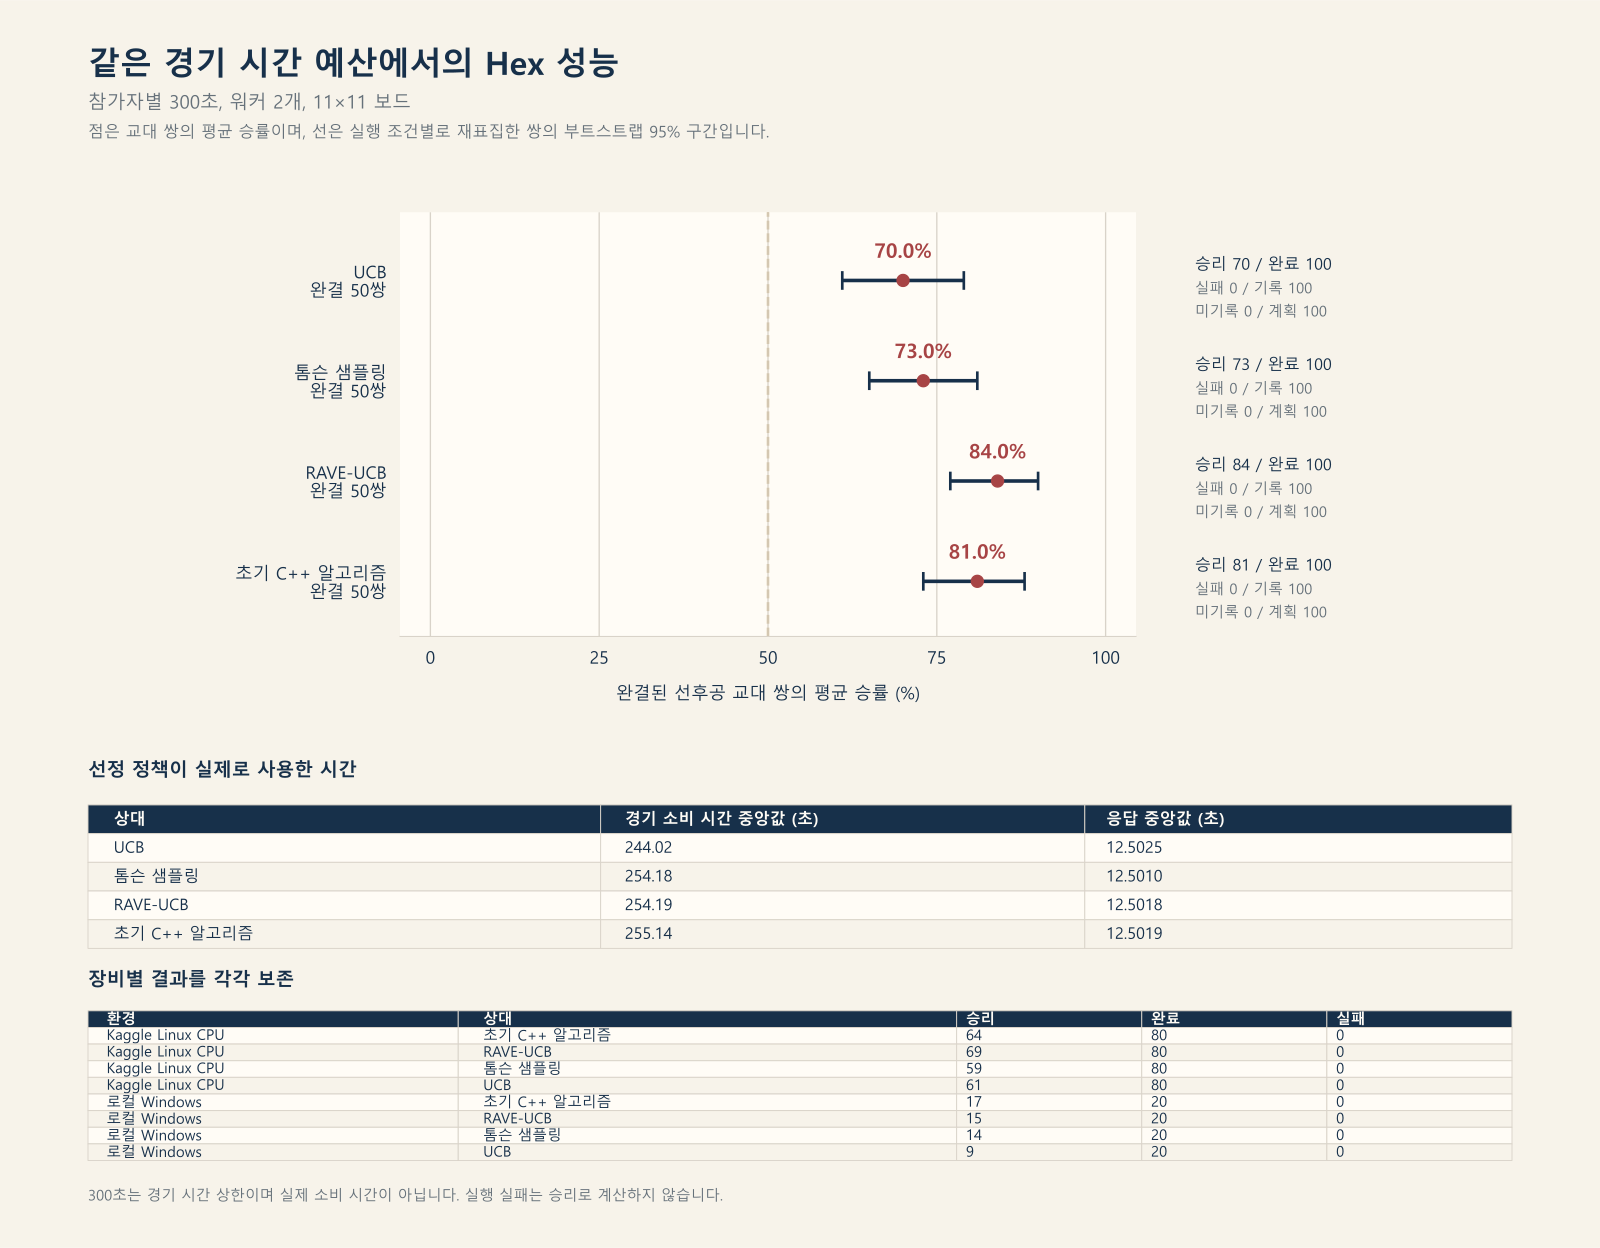
고정한 400경기를 모두 기록했습니다. 완료 400경기, 실패 0건, 미기록 0건입니다. 상대마다 100경기를 배정했으며 승률의 분모는 실제 완료 경기입니다. 선후공 쌍은 같은 상대와 먼저 두는 경기와 나중에 두는 경기를 묶은 단위입니다. 함께 표시한 95% 구간은 관측한 경기 쌍에 따른 승률 추정의 불확실성을 보여 줍니다.
비교 정책인 UCB는 관측 승률에 탐색이 부족한 후보를 위한 보너스를 더해 다음 수를 고릅니다. 톰슨 샘플링은 확률적으로 후보를 선택하고, RAVE-UCB는 UCB에 RAVE 통계를 더한 방식입니다. 같은 계산 조건에서 선택 방식이 달라질 때의 결과를 비교했습니다.
| 상대 또는 제외 조건 | 선정 정책 승리 / 완료 | 경기 승률 | 완료한 선후공 쌍 | 선후공 쌍 평균과 95% 구간 | 실패 / 기록 |
|---|---|---|---|---|---|
| UCB | 70 / 100 | 70.0% | 50 | 70.0%, 61.0–79.0% | 0 / 100 |
| 톰슨 샘플링 | 73 / 100 | 73.0% | 50 | 73.0%, 65.0–81.0% | 0 / 100 |
| RAVE-UCB | 84 / 100 | 84.0% | 50 | 84.0%, 77.0–90.0% | 0 / 100 |
| C++ 기준 구현 | 81 / 100 | 81.0% | 50 | 81.0%, 73.0–88.0% | 0 / 100 |
C++ 기준 구현은 보존된 제출 소스에 난수 시드, 워커 수, 외부 시간 배분과 측정 기록만 추가한 비교 대상입니다. 현재 탐색 위치에서 가상 경기를 끝까지 진행하는 롤아웃을 비롯해, 제출 소스의 수 선택과 확장, 보상 및 전술 판단을 유지하며 AMAF가 갱신되지 않는 상태도 그대로 둡니다. 원본 실행 파일과 바이트까지 같은 대상이라는 뜻은 아닙니다.
300초는 한 경기에서 한 참가자에게 허용한 전체 시간이며 매번 모두 소비하는 시간은 아닙니다. 전술로 바로 수를 선택하거나 경기가 일찍 끝나면 시간이 남습니다. 다음 값은 실제 완료 경기의 요청과 응답에서 측정했습니다.
| 상대 | 선정 정책의 경기 소비 시간 중앙값 (초) | 실제 응답 중앙값 (ms) |
|---|---|---|
| UCB | 244.02 | 12502.45 |
| 톰슨 샘플링 | 254.18 | 12500.97 |
| RAVE-UCB | 254.19 | 12501.79 |
| C++ 기준 구현 | 255.14 | 12501.86 |
선정한 정책의 실제 시간과 메모리 비용
중앙값은 측정값을 작은 순서로 나열했을 때 가운데에 해당하는 값입니다. RSS는 프로세스가 실제 메모리에 올려 사용한 양을 나타내며, MiB는 메모리 크기 단위입니다. 워커 노드 한도는 탐색 트리에 저장할 수 있는 보드 상태의 수를 제한합니다.
| 상대 | 참가자별 경기 사용 시간 중앙값 (초) | 측정한 최대 RSS 중앙값 (MiB) | 워커 노드 한도 도달 / 관측 |
|---|---|---|---|
| C++ 기준 구현 | 255.14 | 125.39 | 3,934 / 4,436 |
| RAVE-UCB | 254.19 | 125.39 | 3,860 / 4,258 |
| 톰슨 샘플링 | 254.18 | 125.39 | 4,114 / 4,696 |
| UCB | 244.02 | 125.40 | 3,711 / 4,150 |
상대별 100경기를 합친 기술 통계이며 장비별 기록은 따로 보존합니다. RSS는 네이티브 프로세스에서 관측한 메모리로 운영체제가 강제한 상한이 아닙니다. 노드 한도는 추가 트리 확장을 제한하며, 한도에 도달해도 선택과 롤아웃은 배정 시간까지 계속합니다. C++ 기준 구현은 제출 소스의 메모리 관리와 워커별 반복 상한을 유지하므로, 시간과 워커 수가 같아도 메모리 설계까지 같은 비교는 아닙니다.
256경기 고정 횟수 평가와 관련 532경기 기록
다음 표는 평가용 시드의 고정 횟수 평가입니다. 수당 전체 탐색 16,000회와 워커 2개를 적용해 256경기를 완료했으며 실패와 미기록은 0건입니다. 경기 시간 평가와 함께 각 예산 조건의 원시 기록을 제공합니다.
| 상대 | RAVE-TS 승리 / 완료 경기 | 승률 | 완료 쌍 | 쌍 단위 95% 구간 | 실패 |
|---|---|---|---|---|---|
| 통계 미갱신 제어 | 55/64 | 85.9% | 32 | 78.1–93.8% | 0 |
| RAVE-UCB | 54/64 | 84.4% | 32 | 76.6–92.2% | 0 |
| 톰슨 샘플링 | 53/64 | 82.8% | 32 | 75.0–90.6% | 0 |
| UCB | 57/64 | 89.1% | 32 | 79.7–96.9% | 0 |
통계 미갱신 제어인 legacy_ts는 선정 정책의 엔진 안에서 AMAF 갱신을 끈 진단 조건이며 제출 소스 전체를 재현한 상대가 아닙니다. 개발 160경기, 고정 횟수 256경기, 원본 소스 기준 4경기, 짧은 정책 시간 비교 48경기와 워커 대국 64경기를 합친 532경기 및 16,768수의 기록도 보존합니다.
고정 횟수 그래프 원본과 고정 횟수 집계에서 수치를 확인할 수 있습니다. 원본 소스의 4/4승 비교는 시간 배분이 서로 다른 두 쌍의 실행 확인이며 충분한 표본의 우위로 확대하지 않습니다.
탐색 통계의 정확성과 대국 성능도 구분합니다. 아래 값은 같은 3×3 보드와 시드에서 1,000회 탐색한 참조 검사입니다. 통계가 갱신되지 않는 기준 구현의 RAVE 반영은 0회, 노드별 행동을 모으는 구현의 AMAF 반영은 13,772회였으며 독립 계산으로 일치를 확인했습니다. 이 수치만으로 승률이나 처리 속도가 개선됐다고 판단하지 않습니다.
문제와 접근 방법
Hex는 같은 색의 돌로 마주 보는 두 변을 연결하는 게임입니다. 11×11 보드에서는 초반 선택지가 많아 모든 수순을 깊이 탐색하기 어렵습니다. 어떤 수에 계산을 배정할지 정하는 정책과 실제 시간 안에 수행할 수 있는 시뮬레이션을 함께 고려했습니다.
스왑 규칙인 파이 룰에 따라 후공은 상대의 첫 수를 본 뒤 색을 바꿀 수 있습니다. 따라서 두 참가자를 선후공으로 교대한 경기 쌍으로 비교하며, 같은 쌍의 두 경기는 같은 장비에 둡니다.
보존된 Python 기준 구현은 상대 차례에도 루트 플레이어의 승리를 최대화합니다. 노드별 보상을 계산하는 구현에서는 각 노드에서 수를 둘 플레이어의 승리로 기록하고 부모가 자식의 값을 반대로 해석하도록 했습니다. C++ 기준 구현은 별도의 플레이어별 보상 기준을 사용하므로 이 Python 오류를 모든 비교 대상에 공통된 문제로 해석하지 않습니다.
RAVE 미갱신의 원인은 이미 둔 트리의 수를 이후 롤아웃 목록에서 찾는 방식에 있습니다. 돌을 놓은 칸에 다시 둘 수 없는 Hex에서는 그 수가 나타나지 않습니다. 따라서 조상 노드 이후 같은 플레이어가 둔 트리와 롤아웃의 수를 함께 모아 노드별 행동 AMAF 통계에 반영하도록 설계했습니다.
경기 시간 비교에서는 독립적인 실행기가 두 참가자에 동일한 외부 경기 예산과 매 수의 탐색 시간을 전달합니다. 이 방식으로 각 엔진의 시간 관리 차이가 평가 조건을 바꾸는 일을 줄였습니다. 정책 선택은 개발 단계에서 마치고, 최종 경기 결과와 기능 진단은 선택한 설정을 평가하는 데 사용했습니다.
시스템 구조
- 조건 고정
정책, 시작 수, 시드와 선후공 교대 쌍 및 예산 설정
- 외부 시간과 심판
입출력 응답을 누적하고 보드, 색상, 차례와 이번 수의 예산 전달
- C++ 병렬 탐색
독립 워커의 MCTS와 AMAF를 계산한 뒤 루트 통계 집계
- 수 적용과 저장
합법 수를 확인하고 시간, 작동 이유와 실패 상태 기록
- 재생과 통계
색상 변화와 시간 배분 및 연결 경로 확인 후 장비별 경기 쌍 집계
Python 실행기는 보존된 Hex 보드 규칙을 사용하고 C++ 참가자와 표준 입출력으로 연결됩니다. 표준 출력은 좌표, 표준 오류는 진단 정보를 전달합니다. 매 요청에 현재 색상을 넣어 스왑 이후에도 두 참가자의 관점을 맞춥니다.
고정 횟수 평가는 V2 입력을, 경기 시간 평가는 해당 수의 탐색 시간과 참가자의 외부 잔여 시간을 전달하는 V3 입력을 사용합니다. 실행기는 입출력 지연을 포함해 누적 시간을 측정하고 두 엔진에 같은 적응형 배분을 적용합니다. 네이티브 탐색은 공통 종료 시각을 매 시뮬레이션 전에 확인하며, 외부 응답 제한도 별도로 유지합니다.
각 루트 워커는 보드와 트리 및 난수를 독립적으로 관리합니다. 새 돌을 놓을 때 연결된 돌의 집합을 합치는 자료구조인 union-find로 연결성을 갱신하고, 탐색 후 시작 노드인 루트의 통계를 합쳐 합법 수를 선택합니다. 전체 탐색 횟수는 모든 워커의 합계입니다. 노드 및 트리 메모리 예산과 운영체제 수준의 프로세스 RSS는 구분합니다.
실험과 검증
개발 평가에서 고정한 정책을 평가용 시드로 검증했습니다. 경기 시간 목록은 네 상대에게 각각 100경기, 전술 목록은 네 제외 조건에 각각 100경기를 배정했습니다. 각 목록의 400경기는 예산과 목적이 서로 다르므로 고정 횟수 평가의 점수와도 분리해 승률을 계산합니다.
선후공을 교대한 두 경기는 같은 장비와 소스 어댑터 조건에 둡니다. 부트스트랩은 관측한 기록을 다시 뽑아 집계했을 때 결과가 얼마나 달라지는지 살펴보는 방법입니다. 여기서는 같은 조건 안에서 경기 쌍 전체를 묶어 다시 추출하고 95% 구간을 계산합니다. 경기별 성공과 실패로 계산하는 Wilson 구간은 쌍 안의 연관성을 반영하지 않는 보조 지표로 구분합니다. 실제 사용 시간과 Windows 및 Kaggle의 결과도 각각 보존합니다.
전술 기능 400경기의 결과와 실제 작동 횟수
스왑 판단, 자신의 즉시 승리, 상대의 즉시 승리 방어와 두 전술 검사를 각각 제외했습니다. 나머지 엔진과 설정은 같으며 수당 전체 탐색 16,000회와 워커 2개로 비교했습니다.
전술 400경기를 모두 기록하고 완료했습니다. 실패와 미기록은 0건입니다.
표의 응답 p50은 다음 수를 요청한 뒤 응답받기까지 걸린 시간의 중앙값입니다. 뒤의 장비별 표에 사용하는 p95는 측정 시간의 약 95%가 그 이하에 놓이는 값으로, 상대적으로 느린 응답의 경향을 보여 줍니다. 시간 값이 작을수록 응답이 빠릅니다.
| 상대 또는 제외 조건 | 선정 정책 승리 / 완료 | 경기 승률 | 완료한 선후공 쌍 | 선후공 쌍 평균과 95% 구간 | 실패 / 기록 |
|---|---|---|---|---|---|
| 스왑 판단 제외 | 51 / 100 | 51.0% | 50 | 51.0%, 46.0–56.0% | 0 / 100 |
| 즉시 승리 검사 제외 | 50 / 100 | 50.0% | 50 | 50.0%, 50.0–50.0% | 0 / 100 |
| 즉시 방어 검사 제외 | 50 / 100 | 50.0% | 50 | 50.0%, 50.0–50.0% | 0 / 100 |
| 전술 검사 모두 제외 | 50 / 100 | 50.0% | 50 | 50.0%, 50.0–50.0% | 0 / 100 |
| 제외 조건 | 집계 대상 | 스왑 | 즉시 승리 | 방어 | 응답 p50 (ms) |
|---|---|---|---|---|---|
| 스왑 판단 제외 | 선정 정책 | 14 | 51 | 66 | 1214.37 |
| 스왑 판단 제외 | 제외 정책 | 0 | 49 | 61 | 1223.43 |
| 즉시 승리 검사 제외 | 선정 정책 | 22 | 50 | 87 | 1186.93 |
| 즉시 승리 검사 제외 | 제외 정책 | 22 | 0 | 87 | 1187.41 |
| 즉시 방어 검사 제외 | 선정 정책 | 15 | 50 | 68 | 1209.31 |
| 즉시 방어 검사 제외 | 제외 정책 | 15 | 50 | 0 | 1207.54 |
| 전술 검사 모두 제외 | 선정 정책 | 21 | 50 | 56 | 1161.11 |
| 전술 검사 모두 제외 | 제외 정책 | 21 | 0 | 0 | 1160.74 |
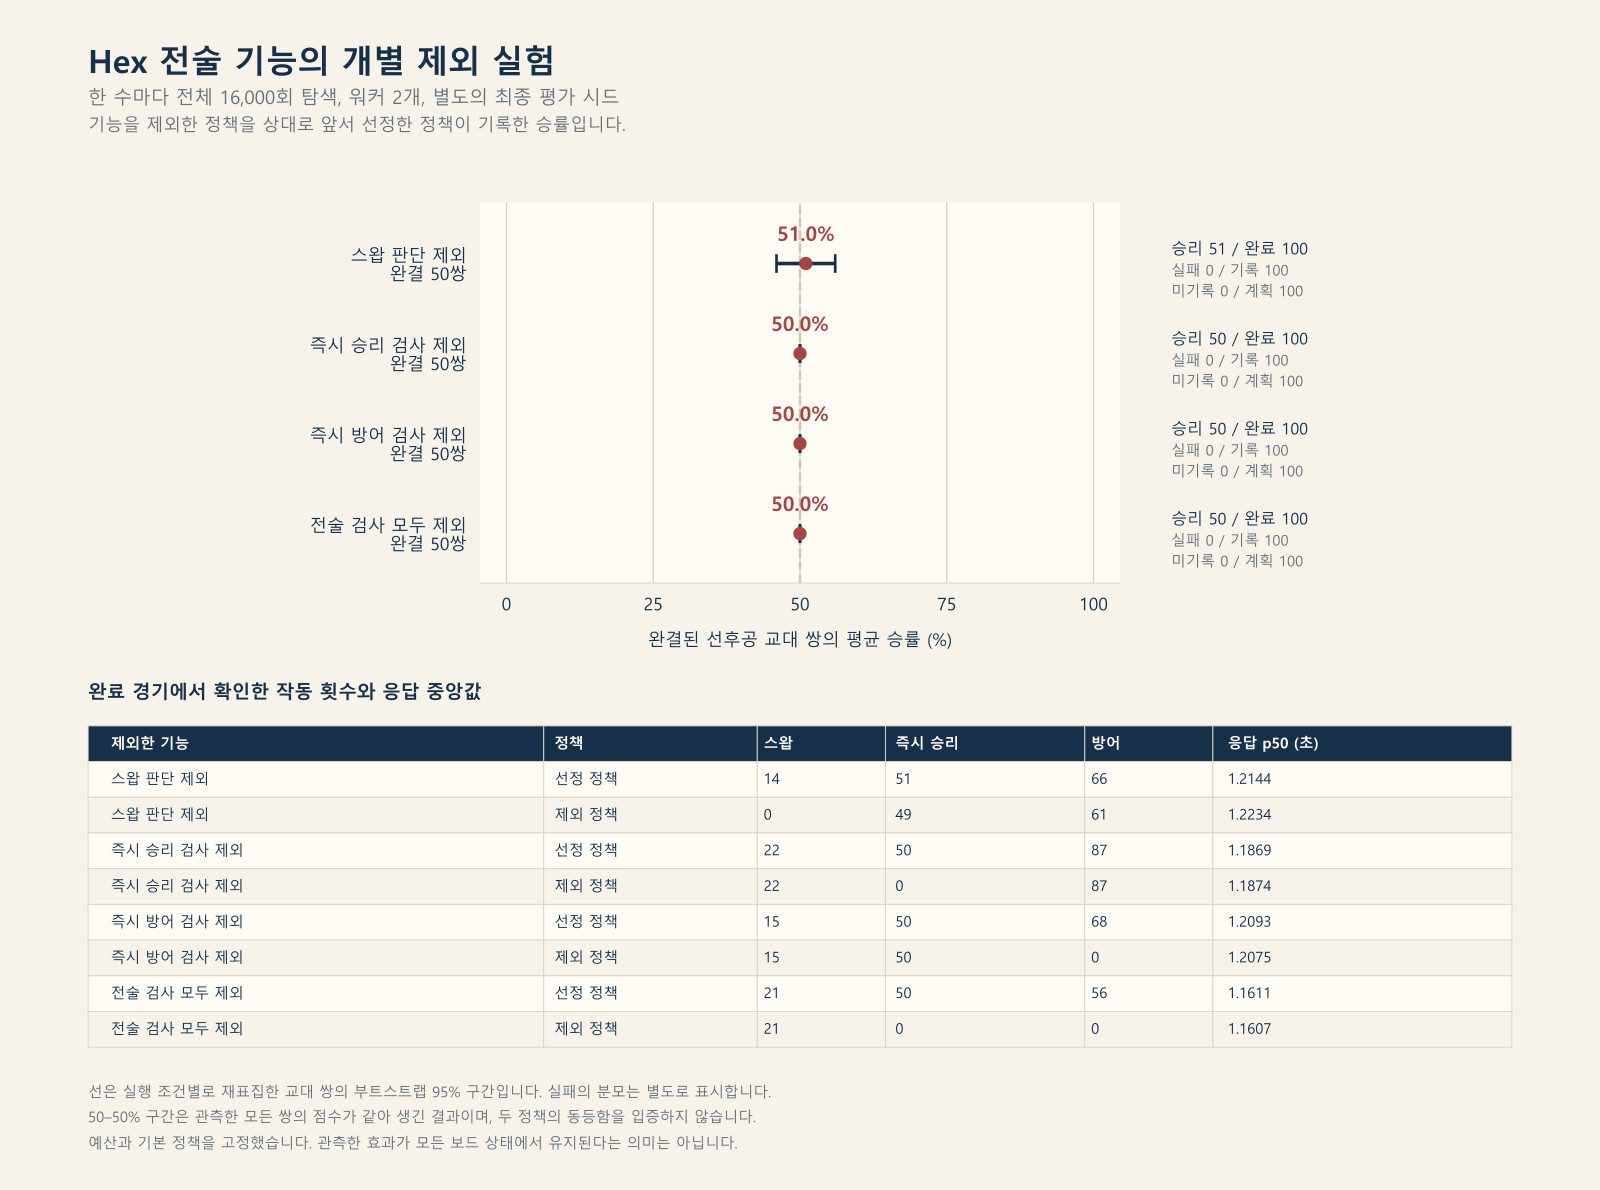
세 즉시 검사 조건의 50–50% 구간은 관측한 교대 50쌍이 모두 1승 1패여서 나타났습니다. 이는 관측된 쌍의 변동이 없다는 뜻이며 전체 상황의 정확한 승률이나 두 기능의 동등함을 증명하지 않습니다. 실제 수순은 즉시 승리에서 48/50쌍, 방어와 두 검사에서 각각 27/50쌍이 같았습니다. 네 조건의 공통 일반 탐색 상태 7,407개는 기록된 워커 시드와 선택 좌표가 모두 일치했습니다.
같은 보드와 차례 및 색상으로 비교한 승리 상태 50개의 외부 응답 중앙값은 즉시 검사 0.191ms, 일반 탐색 231.654ms였습니다. 방어 상태 68개는 각각 0.256ms와 687.677ms였습니다. 일부 선택 수는 다르며, 이 값은 해당 상태의 판단 비용입니다. 전체 에이전트가 같은 배수로 빨라졌다는 뜻이 아니고, 전체 수의 응답 중앙값은 약 1.16–1.22초였습니다. 스왑 제외에 대한 51/100승도 대국 우위의 증명이 아닙니다. 기능 진단에는 개발 단계에서 선정한 정책을 그대로 사용했습니다.
네 비교는 서로 관련된 진단입니다. 기능이 드물게 작동하면 승률의 정보가 부족할 수 있습니다. 구간이 50%를 포함해도 동등함이 증명되는 것은 아니며, 개별 구간으로 여러 비교를 보정한 발견이라고 주장하지 않습니다. 상황별 단위 검사는 해당 분기의 동작을 확인하고 반복 대국은 성능을 확인합니다. 기능을 꺼도 일반 탐색이 같은 수를 찾을 수 있습니다.
여섯 보드 상태의 워커 비용과 장비별 측정표
합법적인 적색 선공 수순을 재생한 2번째, 41번째와 81번째 차례의 비종료 보드 세 개와 이를 전치하고 색을 교환한 정적 보드 세 개를 고정했습니다. 교환한 정적 상태의 적색 선공 경기 도달 가능성은 주장하지 않습니다. 같은 해시의 보드에서 워커 1개, 2개, 4개, 8개가 전체 탐색 횟수를 동일하게 완료하도록 했습니다. 스왑과 즉시 전술로 탐색을 생략하지 않도록 측정에서 비활성화했습니다.
각 요청은 전체 탐색 16,000회를 완료했습니다. 설정별 반복은 Windows 7회, Kaggle 7회이며 같은 보드 해시를 사용했습니다. 두 환경에서 각각 168회인 총 336회를 측정했습니다. 응답 시간의 중앙값은 p50, 95백분위는 p95로 표시하며, p95는 7회 측정값을 보간한 기술 통계입니다.
로컬 Windows
| 보드 상태 | 워커 | 응답 p50 (ms) | 응답 p95 (ms) | 최대 RSS (MiB) |
|---|---|---|---|---|
| 초반 | 1 | 750.84 | 772.82 | 36.7 |
| 초반 | 2 | 380.85 | 417.97 | 37.0 |
| 초반 | 4 | 221.39 | 235.37 | 36.2 |
| 초반 | 8 | 126.07 | 132.52 | 37.1 |
| 중반 | 1 | 744.55 | 775.34 | 31.8 |
| 중반 | 2 | 377.08 | 403.27 | 32.4 |
| 중반 | 4 | 202.09 | 210.50 | 32.7 |
| 중반 | 8 | 120.81 | 122.57 | 32.1 |
| 후반 | 1 | 445.97 | 456.89 | 26.9 |
| 후반 | 2 | 220.85 | 256.89 | 27.3 |
| 후반 | 4 | 129.58 | 137.47 | 28.1 |
| 후반 | 8 | 78.37 | 82.88 | 27.2 |
| 초반의 정적 대칭 상태 | 1 | 748.14 | 775.96 | 36.7 |
| 초반의 정적 대칭 상태 | 2 | 374.58 | 392.48 | 36.9 |
| 초반의 정적 대칭 상태 | 4 | 219.45 | 238.14 | 37.1 |
| 초반의 정적 대칭 상태 | 8 | 128.67 | 134.56 | 35.8 |
| 중반의 정적 대칭 상태 | 1 | 733.31 | 750.95 | 31.8 |
| 중반의 정적 대칭 상태 | 2 | 361.14 | 398.35 | 32.2 |
| 중반의 정적 대칭 상태 | 4 | 207.94 | 227.86 | 32.3 |
| 중반의 정적 대칭 상태 | 8 | 117.84 | 123.64 | 32.0 |
| 후반의 정적 대칭 상태 | 1 | 425.46 | 438.40 | 26.9 |
| 후반의 정적 대칭 상태 | 2 | 218.97 | 229.39 | 27.0 |
| 후반의 정적 대칭 상태 | 4 | 127.32 | 137.99 | 27.9 |
| 후반의 정적 대칭 상태 | 8 | 76.94 | 80.16 | 27.7 |
Kaggle Linux CPU
| 보드 상태 | 워커 | 응답 p50 (ms) | 응답 p95 (ms) | 최대 RSS (MiB) |
|---|---|---|---|---|
| 초반 | 1 | 994.73 | 1017.18 | 35.4 |
| 초반 | 2 | 463.55 | 472.00 | 35.5 |
| 초반 | 4 | 310.55 | 316.42 | 35.3 |
| 초반 | 8 | 300.94 | 304.66 | 28.8 |
| 중반 | 1 | 1018.64 | 1053.02 | 30.7 |
| 중반 | 2 | 469.14 | 491.98 | 30.4 |
| 중반 | 4 | 292.12 | 293.56 | 30.1 |
| 중반 | 8 | 273.21 | 279.87 | 30.2 |
| 후반 | 1 | 574.56 | 580.58 | 25.4 |
| 후반 | 2 | 276.18 | 281.25 | 25.4 |
| 후반 | 4 | 175.10 | 176.98 | 25.6 |
| 후반 | 8 | 160.45 | 164.55 | 21.6 |
| 초반의 정적 대칭 상태 | 1 | 996.43 | 1021.10 | 35.3 |
| 초반의 정적 대칭 상태 | 2 | 463.65 | 466.60 | 35.4 |
| 초반의 정적 대칭 상태 | 4 | 310.55 | 356.92 | 35.3 |
| 초반의 정적 대칭 상태 | 8 | 305.58 | 327.59 | 29.1 |
| 중반의 정적 대칭 상태 | 1 | 1002.11 | 1039.90 | 30.5 |
| 중반의 정적 대칭 상태 | 2 | 464.07 | 477.57 | 30.5 |
| 중반의 정적 대칭 상태 | 4 | 289.78 | 296.24 | 30.2 |
| 중반의 정적 대칭 상태 | 8 | 276.70 | 282.70 | 26.9 |
| 후반의 정적 대칭 상태 | 1 | 578.56 | 589.99 | 25.5 |
| 후반의 정적 대칭 상태 | 2 | 273.85 | 276.79 | 25.5 |
| 후반의 정적 대칭 상태 | 4 | 173.18 | 175.82 | 25.5 |
| 후반의 정적 대칭 상태 | 8 | 160.35 | 166.11 | 19.8 |
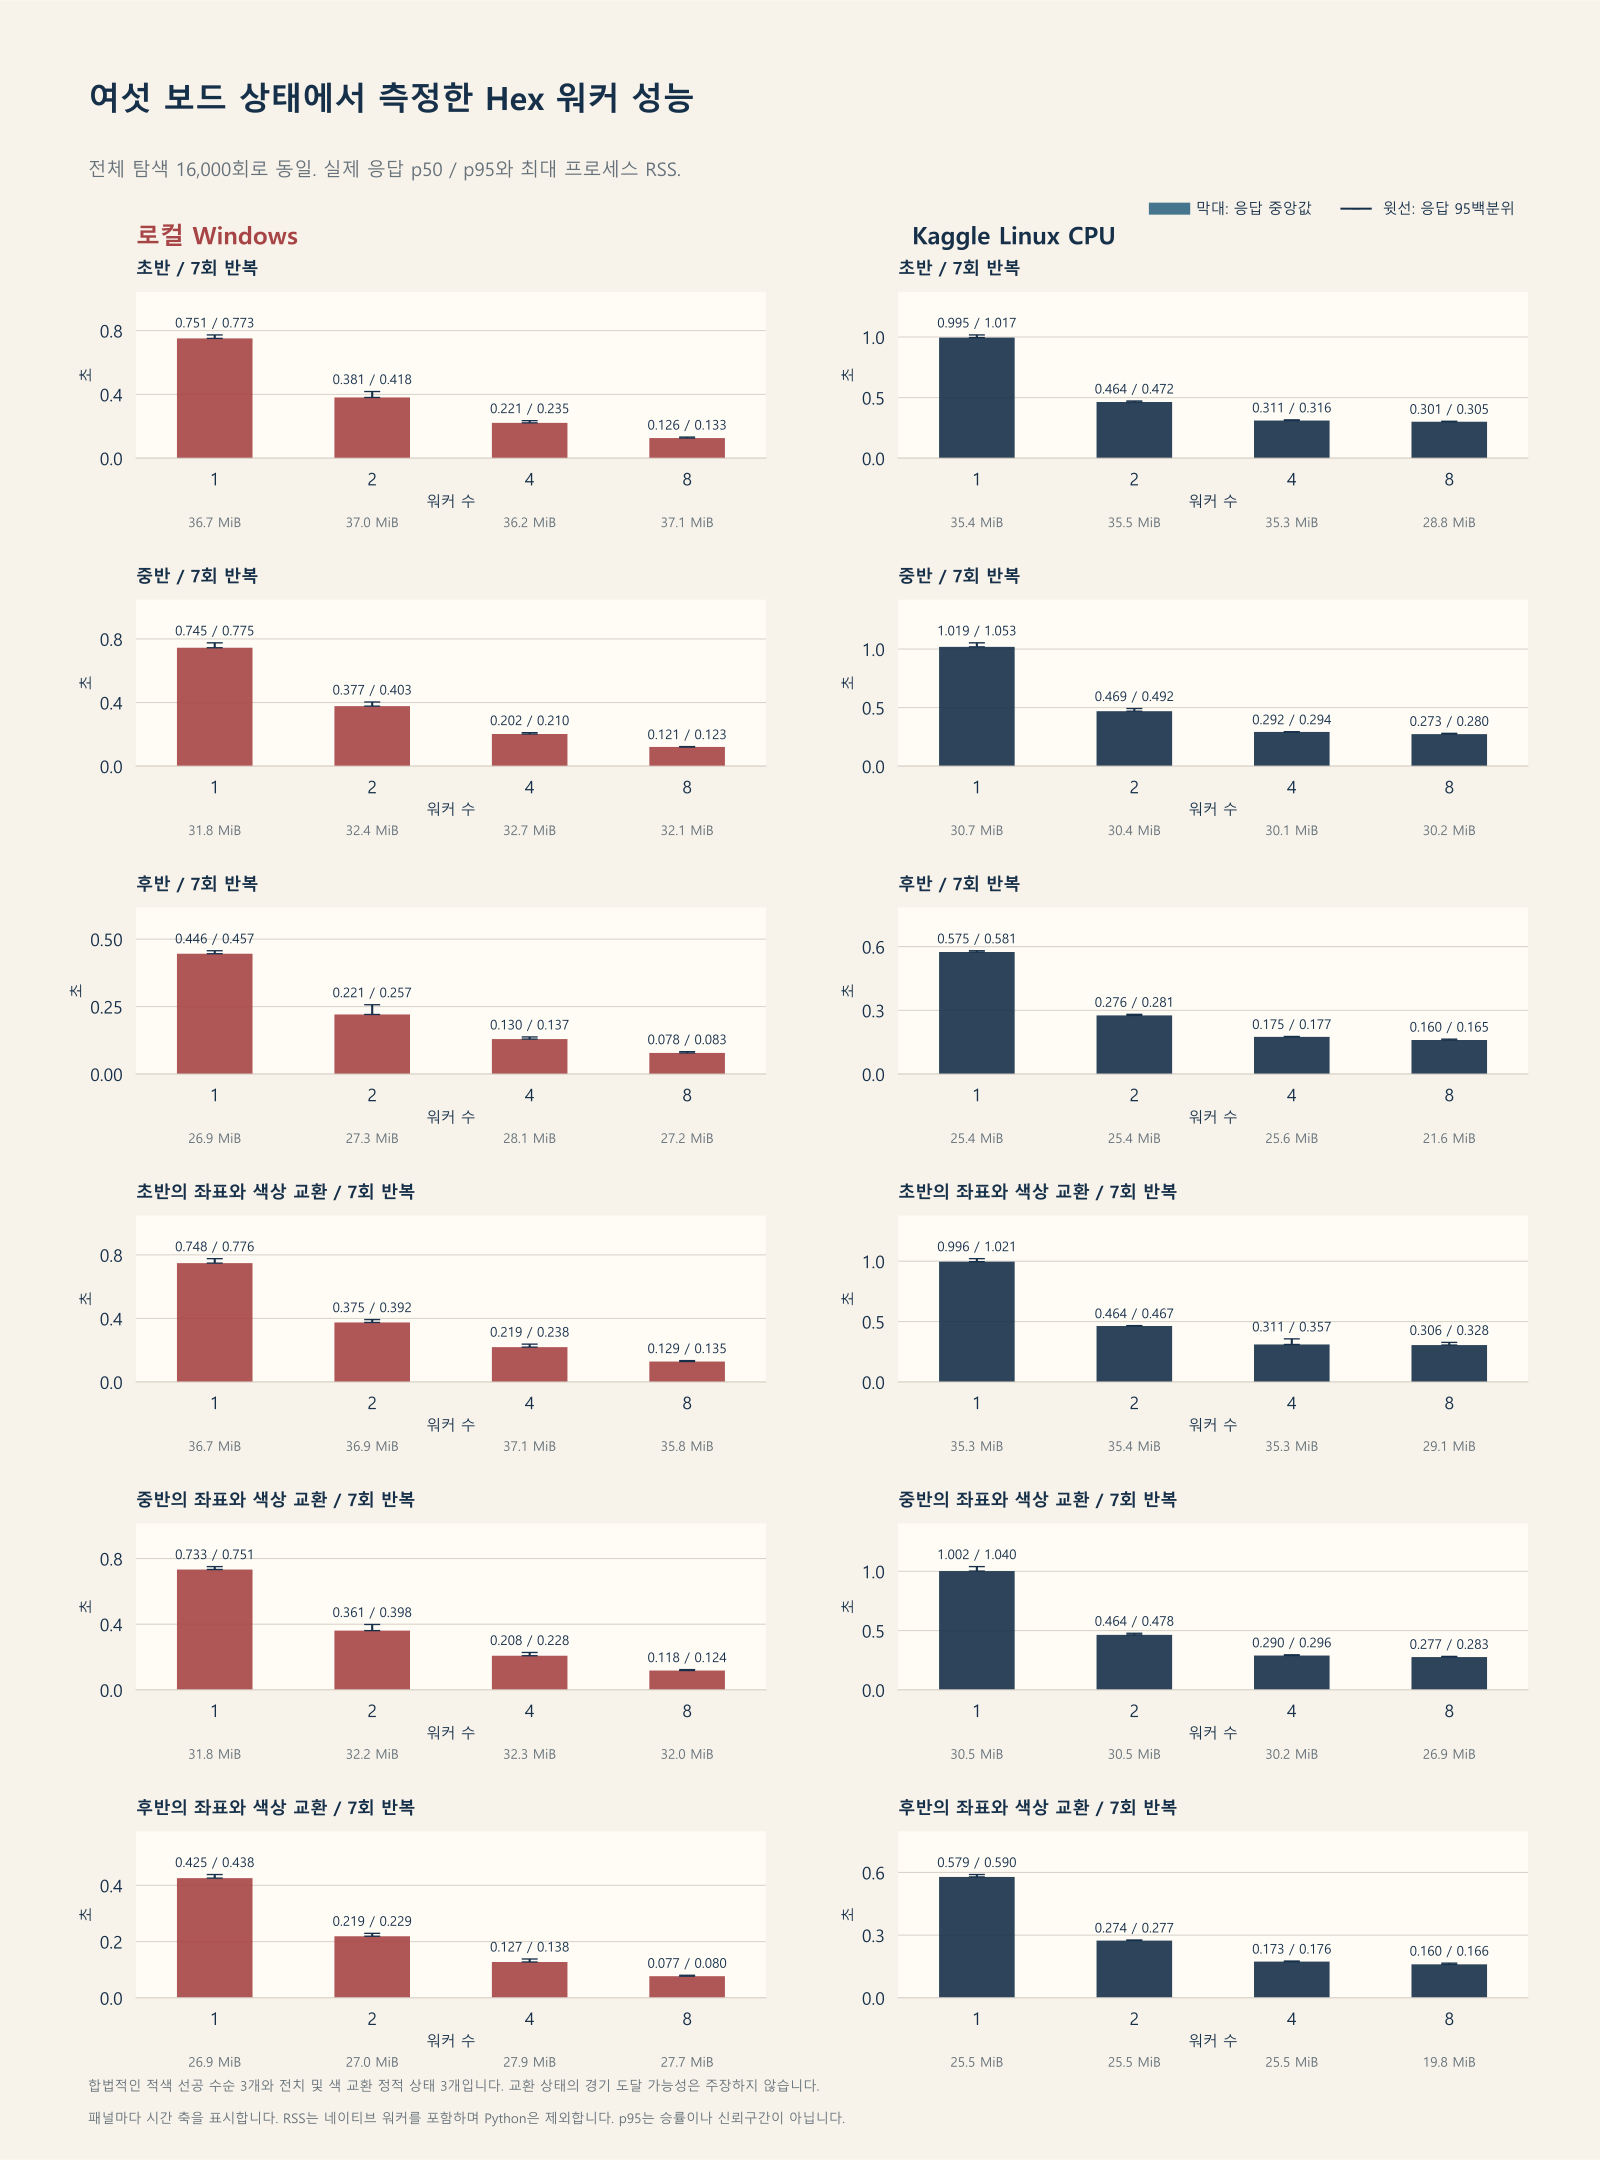
표의 응답 시간은 p50 및 p95입니다. 최대 RSS는 각 설정의 7회 측정 중 가장 높게 기록된 네이티브 프로세스의 메모리이며, 워커를 포함하고 Python 실행기는 제외합니다. Windows는 최대 작업 집합, Linux는 VmHWM을 기록하므로 장비 간 메모리를 동일한 측정 방식으로 비교하지 않습니다. 미측정은 0으로 바꾸지 않습니다. 상태와 장비별 시간 축을 구분하며, 처리 속도가 대국 승률을 뜻하지 않습니다. 전체 열두 패널은 원본 그래프에서 확대해 확인할 수 있습니다.
개발 단계의 선택과 짧은 정책 및 워커 대국
개발 정책 96경기와 기능 64경기를 수행한 뒤 RAVE-TS를 선정했습니다. 추가로 비교한 변경 조건 네 개는 사전에 정한 채택 기준을 통과하지 못해 결과를 보존하고 중단했습니다. 정확성 수정은 대국 승률에 따라 되돌리는 항목이 아닙니다.
| 탐색적 평가 | 기록 / 완료 | 실패 | 범위 |
|---|---|---|---|
| 정책 시간 비교 | 48 / 48경기 | 0 | 수당 0.25초, 상대별 교대 8쌍 |
| 워커 대국 | 64 / 64경기 | 0 | 워커 1개, 2개, 4개, 8개와 UCB 2워커 비교 |
개발 정책 그래프, 단일 보드의 비용 그래프와 해당 집계를 보존합니다. 작은 표본의 탐색적 결과와 참가자별 300초 평가를 구분해 해석합니다.
Kaggle Linux와 별도로 준비한 Windows 환경에서 소스 빌드와 실행 경로를 확인했습니다. 개발과 고정 횟수 평가 등을 포함한 532경기, 경기 시간과 전술 평가 800경기 및 통합 대국 4경기를 합친 1,336경기와 53,199수를 재생 검증했으며, 원본 자료 64개와 보존 대상 실험 및 설정 1,155개의 보존 여부도 확인했습니다. 기록 재생과 대국 재실행은 별도로 제공합니다.
실제 환경 검증과 짧은 통합 실행의 범위
sanitizer는 프로그램을 실행하면서 잘못된 메모리 접근이나 정의되지 않은 연산을 찾는 검사 도구입니다. ASan은 메모리 접근 오류를, UBSan은 C++ 규칙상 동작이 정의되지 않은 연산을 확인합니다. 아래 표는 이러한 구현 검사와 실제 대국 실행을 구분한 기록입니다.
| 환경과 확인 항목 | 실제 결과 | 범위 |
|---|---|---|
| Kaggle CPU 실행 도구 | Python 테스트 107개 통과, 건너뛴 항목 0개 | 소스 추출과 해시, 소스 빌드, 보존한 심판 및 어댑터 검사 |
| C++ 자체 검증과 sanitizer | 15개 검사와 보드 배치 19,683개, ASan 및 UBSan 프로토콜 검사 6개 통과 | 명시한 입력과 실행 경로의 검사 |
| V3 통합 대국 | 4경기 완료, 실패 0건, 100수 재생 검증 | 참가자별 5초의 짧은 통합 확인 |
| 별도 Windows 소스 빌드 | 현재 구현 검사 64개, 심판 검사 18개, 어댑터 검사 23개 통과 | Python 3.12.7, MinGW g++ 14.2.0과 외부 패키지가 없는 가상환경 |
| 원본 실행 파일의 운영체제 제한 | Linux 실행 파일 전용 검사 2개는 Windows에서 제외 | Windows 빌드에서 대응하는 V2 동작 두 가지를 별도 확인 |
| 전체 저장 기록 검증 | 1,336경기와 53,199수 재생 검증 | 해시, 규칙, 참가자 색상, 시간 기록과 승리 연결 확인 |
별도의 Kaggle 체크포인트 작업은 소스 빌드와 테스트를 마친 뒤 첫 평가 대국 전에 멈췄고, 미실행 상태와 결과 ZIP을 정확히 저장했습니다. 기록된 경기가 0개인 이 작업은 중단과 저장 동작을 확인한 근거이며 경기력 집계에 더하지 않습니다. 지정한 1초는 빌드 이후 평가기의 중단을 확인하기 위한 설정으로, 전체 작업이 1초 안에 끝났다는 뜻은 아닙니다.
Windows 11과 Python 3.12.7, Kaggle Linux와 Python 3.13.15에서 실제 검증했습니다. 이를 모든 Python 버전이나 WSL, 모든 컴파일러에 대한 검증으로 확대하지 않습니다. 두 환경의 실행은 같은 프로젝트 운영자가 수행했으며 독립적인 외부 평가자의 검토를 의미하지 않습니다.
한계와 해석
결과는 명시한 내부 상대와 시작 조건, 계산 예산에 적용됩니다. 전체 Hex 에이전트의 순위나 Davis 및 HexHex에 대한 승률을 뜻하지 않습니다. 평가용 시드도 처음 보는 시작 좌표를 보장하지 않습니다.
C++ 기준 구현의 어댑터는 시간과 워커 수를 맞췄지만 트리 표현, 난수 흐름과 메모리 증가는 선정 정책의 엔진과 다릅니다. 기준 구현의 워커별 탐색 상한도 유지합니다. 따라서 전체 점수 차이를 AMAF 갱신 방식 하나의 인과 효과로 설명하지 않습니다.
고정 횟수의 같은 빌드와 시드 및 설정에서 반복을 확인합니다. 서로 다른 표준 라이브러리는 난수 분포가 달라 수순까지 같다고 보장하지 않습니다. 시간 제한은 장비 부하와 실행 순서에도 영향을 받습니다. 동시에 두 경기를 수행한 CPU 조건과 워커 측정의 조건을 구분하며, 워커 수를 CPU 코어 수로 설명하지 않습니다.
Davis와 HexHex의 보존한 개별 경기
| 기록된 에이전트 | 상대 | 시작 순서 | 기록 결과 | 근거 |
|---|---|---|---|---|
| RAVE-TS | Davis 7 | 선공 | 승리, 47턴 | 원본 캡처 |
| RAVE-TS | Davis 10 | 선공 | 승리, 33턴 | 원본 캡처 |
| RAVE-TS | HexHex | 후공 | 패배, 40턴 | 원본 캡처 |
| MCTS 기준 에이전트 | HexHex | 후공 | 패배, 50턴 | 원본 캡처 |
Davis는 기록된 대국에서 상대한 온라인 사이트의 에이전트입니다. 외부 실행 파일과 정확한 설정 및 전체 토너먼트 원본은 제공되지 않으므로 네 경기의 캡처를 내부 상대의 정량 평가에 합산하지 않습니다.
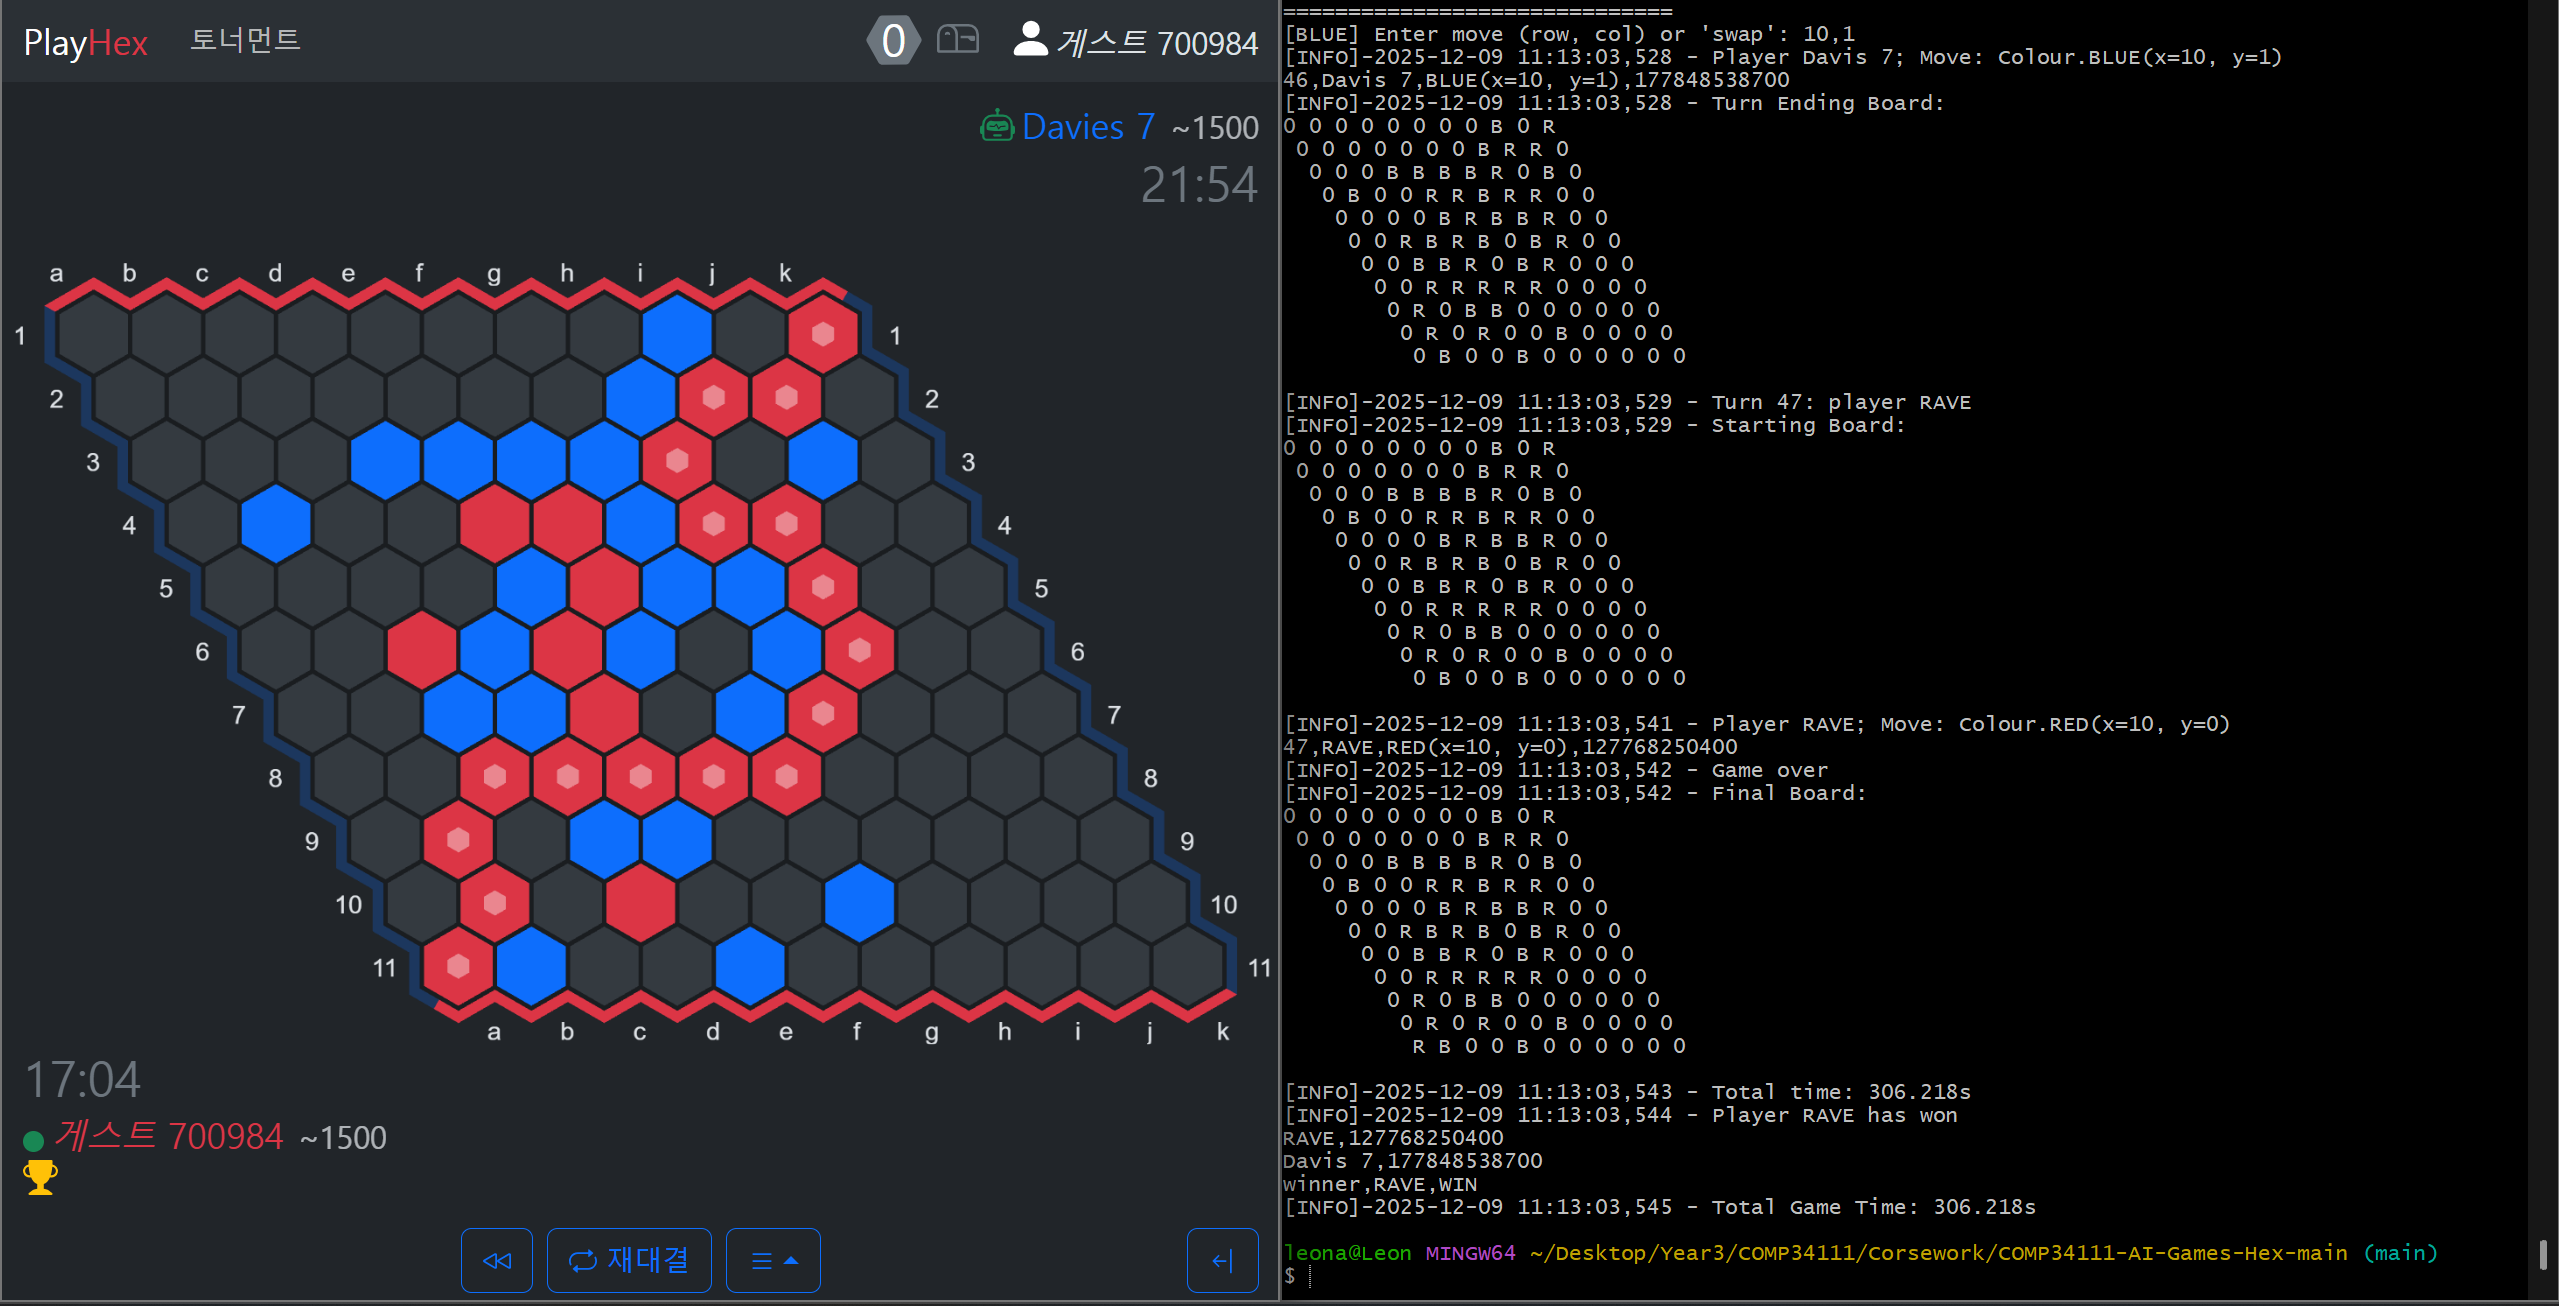
HexHex 상대 패배 두 경기는 시드와 첫 수를 맞춘 비교가 아니므로 종료 턴의 차이로 개선 폭을 판단하지 않습니다. 원본 경기 자료와 네 캡처는 저장소에 유지했습니다.
이 프로젝트는 탐색 통계의 정확성을 확인하고, 실제 계산 예산과 실행 오류를 관리하며, 반복 대국과 재현 자료로 선택을 설명하는 역량을 보여줍니다. 구현의 정확성과 특정 평가 조건의 경기력을 각각의 근거로 설명합니다.
실행 방법
소스를 내려받아 Python 3.10 이상과 C++17 컴파일러를 준비합니다. 에이전트는 표준 라이브러리를 사용하며 g++, clang++ 또는 zig c++로 대상 운영체제의 실행 파일을 빌드합니다. 로컬 검증에는 GPU와 Kaggle 계정 또는 Docker가 필요하지 않습니다.
환경 확인, 소스 빌드와 짧은 탐색
프로젝트 루트에서 실행합니다.
python -m hexai doctor
python -m hexai build
python scripts/build_legacy_benchmark.py --output .local/bin/legacy_benchmark
python -m unittest discover -s tests -v
python -m hexai predict --board "R00,000,000" --colour B --turn 2 --iterations 1000 --workers 1 --swap 0
컴파일러를 검색하지 못하면 경로를 준비하거나 --compiler로 지정합니다. 실행 파일은 .local/bin/에 만들며 보존된 제출본을 덮어쓰지 않습니다. 같은 경기 시간 비교에서는 고정 목록의 상대 경로와 동일한 이름으로 C++ 기준 구현의 어댑터를 빌드합니다.
저장된 결과를 새 대국 없이 검증
python scripts/verify_release.py --manifest reports/release-manifest-v2.json --output .local/release-verification.json소스 및 기록의 해시, 고정 목록의 경기 범위, 참가자와 색상 변화, 합법 수, 시간 배분과 승리 연결 경로를 확인합니다. 저장한 수의 재생은 탐색을 다시 수행하거나 최적 수를 증명하는 검사가 아닙니다. 각 기록은 해당 실행에 사용한 보관 소스에 연결합니다.
경기 시간 평가를 다시 실행하고 이어가기
python -m hexai evaluate --config configs/deep/shared-time.json --output .local/deep-shared-time --max-wall-seconds 33000 --checkpoint-margin-seconds 120
python -m hexai evaluate --config configs/deep/shared-time.json --output .local/deep-shared-time --max-wall-seconds 33000 --checkpoint-margin-seconds 120 --resume
전체 400경기에는 충분한 CPU 시간이 필요합니다. 호환되는 목록, 소스와 장비의 기록을 확인해 이어 실행하며 미완료를 완료로 표시하지 않습니다. 이미 기록한 실패를 더 좋은 결과로 자동 교체하지 않습니다. 공개 Kaggle 패키지와 전술 및 보드별 측정의 세부 명령은 한국어 재현 문서에 제공합니다.
저장된 전술 기록의 실제 재분석
python tools/analysis/analyze_tactical_traces.py --summary reports/deep/aggregates/tactical-ablation.json --runs reports/deep/evaluation/tactical-ablation/hex-tactical-ablation-v1/evaluation-shard00 reports/deep/evaluation/tactical-ablation/hex-tactical-ablation-v1/evaluation-shard01 --output .local/tactical-trace-analysis표준 라이브러리로 수순, 실제 작동 이유와 응답을 다시 계산합니다. 에이전트를 실행하거나 새 대국을 만들지 않으며 최종 결과로 정책을 조정하지 않습니다. 참가자별 전체 비용은 tools/analysis/analyze_deep_evidence.py에서 같은 두 기록 폴더로 확인할 수 있습니다.
그래프를 다시 만드는 도구만 Python 3.11 이상과 Matplotlib를 선택 설치합니다. 에이전트의 Python 3.10 이상 실행 환경과 구분합니다.
코드와 자료
- GitHub 저장소
- 소스와 평가 자료 다운로드
- 현재 C++ 탐색 엔진
- 한국어 시스템 구조
- 한국어 실험과 결과 해석
- 한국어 재현 안내
- 한국어 실행 환경 설명
- 한국어 외부 예산과 입력 규약
- 한국어 검증 범위와 한계
- 경기 시간 평가의 실제 집계
- 전술 진단의 실제 집계
- 고정된 정책 선택
- 선택 실행하는 원시 기록 분석 도구
- 선택 설치하는 그래프 도구
다운로드 페이지에서 ZIP 준비하기를 누르면 파일을 받아 무결성을 확인합니다. 검사가 끝난 뒤 검증된 ZIP 저장으로 소스와 영문 및 한국어 문서, 원시 평가 기록과 보존한 제출본을 함께 내려받을 수 있습니다. 현재 운영체제의 실행 파일은 소스에서 빌드합니다.
소스와 평가 자료 다운로드GitHub에서 소스 코드 보기