


프로젝트 개요
영어 연구 논문을 읽다가 생긴 질문에 답을 얻고, 그 답을 원문과 직접 대조할 수 있도록 만든 로컬 질의응답 시스템입니다. 사용자 컴퓨터에서 실행하며, 텍스트를 추출할 수 있는 영어 PDF 한 편을 업로드하면 페이지와 절을 분석하고 한국어 또는 영어 질문에 답변합니다.
영어 답변은 검색한 원문 문장을 추출해 구성하고, 한국어 답변은 해당 문장을 번역합니다. 검색을 위해 본문을 작은 조각인 청크로 나누고, 답변에 해당 청크의 식별자와 페이지 및 절을 연결합니다. 각 답변 문장에 대응하는 원문도 따로 표시하므로, 어떤 부분을 근거로 답했는지 직접 확인할 수 있습니다. FastAPI 서버와 Streamlit 화면을 Docker Compose로 함께 실행하도록 구성해 업로드부터 질문, 답변과 근거 검토까지 구현했습니다.
평가 결과와 한계를 공개한 연구 프로토타입으로, 검색과 번역, 출처 추적을 하나의 서비스로 구성했습니다. 설계 대안을 비교해 전체 답변 품질의 향상이 확인되지 않은 기능은 기본 설정에서 제외하고, 채택한 구현과 판단 근거를 재현 가능한 자료로 남겼습니다.
핵심 결과
평가에서는 같은 내용을 영어와 한국어로 묻는 두 질문을 한 그룹으로 묶었습니다. 두 언어의 답변이 모두 조건을 충족해야 해당 그룹을 통과로 셉니다. 아래의 ’필수 어휘’는 답변에 필요한 정보가 담겼는지 자동으로 확인하기 위해 지정한 단어와 표현이며, 그 어휘가 있다는 사실만으로 문장 전체가 정확하다는 뜻은 아닙니다.
- 평가에 사용한 논문
- 30편
- 563페이지, 검색용 청크 2,463개
- 답변 가능한 질문에 응답
- 49/80
- 평가 논문 20편에서 두 언어가 모두 응답한 그룹
- 필수 어휘 모두 포함
- 11/80
- 두 언어가 모두 통과한 자동 검사이며 정확도가 아님
- 별도 환경의 표본 재현
- 12/12
- 선정한 답변, 원문 대응과 인용이 일치
필수 어휘를 모두 포함한 그룹은 비교 구현과 최종 구현 모두 11/80입니다. 응답한 그룹은 50/80에서 49/80, 허용된 근거 페이지를 인용한 그룹은 32/80에서 31/80으로 바뀌어, 최종 구현이 전체 답변 성능을 높였다고 판단할 근거는 얻지 못했습니다.
자동 검사 전체 결과와 평가 단위
| 검사 항목 | 비교 구현 | 최종 구현 |
|---|---|---|
| 출력 형식 준수 | 240/240 | 240/240 |
| 답변 가능한 질문에 응답 | 50/80 | 49/80 |
| 필수 정보의 어휘 표지 모두 포함 | 11/80 | 11/80 |
| 허용된 근거 페이지 중 하나를 인용 | 32/80 | 31/80 |
| 근거가 없는 요청을 거절 | 18/20 | 18/20 |
| 잘못된 전제의 요청을 거절 | 2/20 | 2/20 |
| 의미상 정확도 | 독립 측정 없음 | 독립 측정 없음 |
두 열은 사전학습 검색 및 번역 모델을 활용해 직접 개발한 같은 시스템의 실험 구성입니다. 비교 구현을 기준으로 설계 대안을 검증하고, 채택 기준과 출력 변화를 검토해 최종 구현을 확정했습니다.
출력 형식은 개별 출력 240개를 검사합니다. 나머지 항목은 같은 내용을 영어와 한국어로 묻는 그룹 단위이며, 두 언어가 모두 조건을 충족해야 통과합니다. 최종 구현의 언어별 필수 어휘 포함은 영어 43/80, 한국어 15/80이고, 두 언어가 같은 그룹에서 모두 통과한 경우가 11/80입니다.
어휘가 등장해도 문장이 틀릴 수 있고, 올바른 동의어를 검사에서 놓칠 수도 있습니다. 페이지 인용과 응답 여부도 사실 정확성을 보장하지 않습니다.
문제와 접근 방법
논문에는 전문 용어와 수치, 적용 조건이 함께 등장합니다. 관련 페이지를 인용한 답변도 질문이 요구한 내용을 빠뜨릴 수 있어, 출처의 존재뿐 아니라 원문과 답변의 대응 관계를 확인할 수 있어야 했습니다. 한국어 질문과 영어 논문 사이의 언어 차이도 검색과 번역 과정에 영향을 줍니다.
페이지와 절의 경계를 유지하며 기본 1,200자 청크를 만들고, 경계에서 문맥이 끊기는 것을 줄이려고 인접 청크 사이에는 200자를 겹쳤습니다. 단어의 일치를 중심으로 찾는 BM25와 문장의 의미를 숫자 배열로 표현해 비교하는 다국어 E5를 함께 사용했습니다. 두 검색기의 순위를 합치는 RRF로 후보를 모은 뒤, 질문과 후보 문장을 함께 읽는 교차 인코더가 관련성을 다시 판단합니다. 선택한 근거 문장에서 답변을 구성하고, 한국어 요청에는 NLLB 번역 모델을 적용합니다.
페이지와 청크 식별자를 처리 과정 전체에 유지하고, 답변 문장에 원문을 연결했습니다. 수치와 식별자, 단위 및 일부 범위 표현도 검사합니다. 이러한 검사는 관찰 가능한 오류를 찾는 절차이므로 의미의 정확성까지 보장한다고 해석하지 않습니다.
시스템 구조
- 논문 분석
PDF에서 페이지와 절을 추출하고 출처를 보존한 청크 생성
- 근거 검색
BM25와 다국어 E5 검색, RRF 통합 및 교차 인코더 재정렬
- 답변 구성
근거와 응답 여부 판단 후 원문 추출 또는 한국어 번역
- 원문 대조
답변 문장에 원문, 페이지, 절과 청크 식별자 연결
FastAPI는 화면이 업로드, 분석과 질의응답을 요청할 수 있는 API를 제공하고, Streamlit은 질문과 답변, 인용 원문을 표시합니다. SQLite에는 논문 정보와 작업 상태를 저장합니다. 문장의 의미를 숫자 배열로 바꾼 임베딩은 논문별로 저장해 두고 모델과 함께 재사용하므로, 반복 질문마다 같은 준비 작업을 되풀이하지 않습니다. 최대 20 MiB의 PDF를 받고 작업의 대기, 실행, 완료와 실패 상태를 구분합니다.
기본 서비스는 사용자가 선택한 논문 한 편 안에서 답을 찾습니다. 평가용 논문 모음인 코퍼스와 서비스의 업로드 자료는 별도로 관리하며, 평가 자료를 서비스 Docker 이미지에 포함하지 않습니다.
실험과 검증
논문 30편에서 같은 내용을 두 언어로 묻는 의미 그룹 180개, 버전별 출력 360개를 구성했습니다. 논문 10편은 기능과 설정을 선택하는 개발에, 나머지 20편은 최종 비교에 사용했습니다. 검색 및 번역 모델의 버전과 설정, 입력 자료와 측정 당시 소스를 고정하고 실제 출력과 함께 공개했습니다. 파일 내용의 변경을 확인하는 식별값인 해시도 기록해 같은 자료로 다시 실행하는지 확인할 수 있게 했습니다.
개발 자료에서는 질문이 요구한 세부 항목을 추적하고, 검색된 문장 주변의 문맥을 복원하며, 필요한 경우 제한적으로 다시 검색하는 방법을 세 가지 조합으로 비교했습니다. 사전에 정한 채택 기준을 충족하지 못해 해당 기능을 기본 설정에서 비활성화했습니다. 원문 대조 기능과 영어 문장 안에서 숫자 하나로 표현되는 측정값인 스칼라를 인식하는 수정은 유지했습니다.
설계 대안의 비교와 중단 판단
아래의 ’응답 그룹 손실’은 비교 구현이 답했던 질문에 실험 구성이 더 이상 답하지 못한 경우입니다. ’부정 질문’은 근거가 없거나 전제가 잘못돼 답변을 거절해야 하는 질문을 뜻합니다. 따라서 필수 어휘 포함은 늘리고, 응답 손실과 부정 질문에 대한 답변은 줄이는 방향으로 판단했습니다.
| 실험 구성 | 필수 어휘 모두 포함 | 비교 구현의 응답 그룹 손실 | 부정 질문에 응답 | 판단 |
|---|---|---|---|---|
| 비교 구현 | 8/40 | 0개 | 10/20 | 비교 기준 |
| 요청 항목 추적과 문맥 복원 1차 | 10/40 | 4개 | 10/20 | 제외 |
| 요청 항목 추적과 문맥 복원 2차 | 10/40 | 3개 | 11/20 | 제외 |
| 문맥 복원과 원문 대응 조합 | 9/40 | 3개 | 11/20 | 제외 |
채택 조건은 필수 어휘를 모두 포함한 그룹 최소 2개 증가, 부정 질문에 대한 추가 응답 없음, 비교 구현의 응답 그룹 손실 최대 1개와 실행시간 비율 2.5 이하였습니다. 세 구성 모두 조건을 충족하지 못해 기본 설정에서 제외했습니다. 선언한 실험 범위에서 내린 판단이며 달성 가능한 최고 성능을 확인한 결과는 아닙니다.
| 검증 항목 | 완료한 범위 |
|---|---|
| 회귀 테스트 | 수정 후에도 기능이 유지되는지 확인하는 검사로, Windows와 별도 Linux 환경에서 각각 382개 통과 |
| 공개 자료 검사 | 두 환경에서 각각 검증기 11개 통과 |
| 원문 대응 무결성 | 출력 360개의 대응 단위 708개를 저장된 근거에서 재구성 |
| 실제 모델 실행 재현 | 논문 4편의 사전 선정 출력 12개에서 답변, 대응 원문과 인용 일치 |
Linux 재현은 같은 물리 호스트의 다른 실행 환경에서 에이전트가 수행했습니다. 전체 출력 360개를 모델로 재실행하거나 독립적인 외부 사용자가 사실을 검증한 결과는 아닙니다. 실행시간과 재정렬 점수의 부동소수점 차이는 출력 일치 비교에서 제외했습니다.
한계와 해석
주요 실패는 질문이 요구한 정보의 누락과 한국어 번역 오류입니다. 관련 페이지를 찾고도 목록이나 수치, 비교 조건을 빠뜨렸으며 전문 용어가 다른 의미로 번역되기도 했습니다. 잘못된 전제의 요청을 거절한 그룹은 2/20으로, 이 정책에도 한계가 있습니다.
정답과 근거의 기준을 표시한 평가 레이블은 AI 보조 원문 정리로 작성했으며 독립적인 사람의 사실 평가는 수행하지 않았습니다. 평가 논문 20편도 과거 문서 처리와 검색 실행 확인에 사용한 이력이 있어 처음 접한 문서 전체로 볼 수 없습니다. 정식 비교 전에 중단한 실행과 진행 정보 확인 이력은 평가 문서에 공개했습니다. 이미 공개한 질문은 이후 개발에서 새로운 성능 시험보다 기능이 유지되는지 확인하는 회귀 자료로 취급해야 합니다.
현재 버전은 스캔 이미지에서 글자를 읽는 OCR, 표와 그림의 시각적 추론, 신뢰할 수 있는 수식 해석과 여러 논문 간 비교를 지원하지 않습니다. 이 프로젝트는 검색과 번역, 근거 추적을 연결하고 평가 실패까지 근거로 설명하는 역량을 보여줍니다.
실행 방법
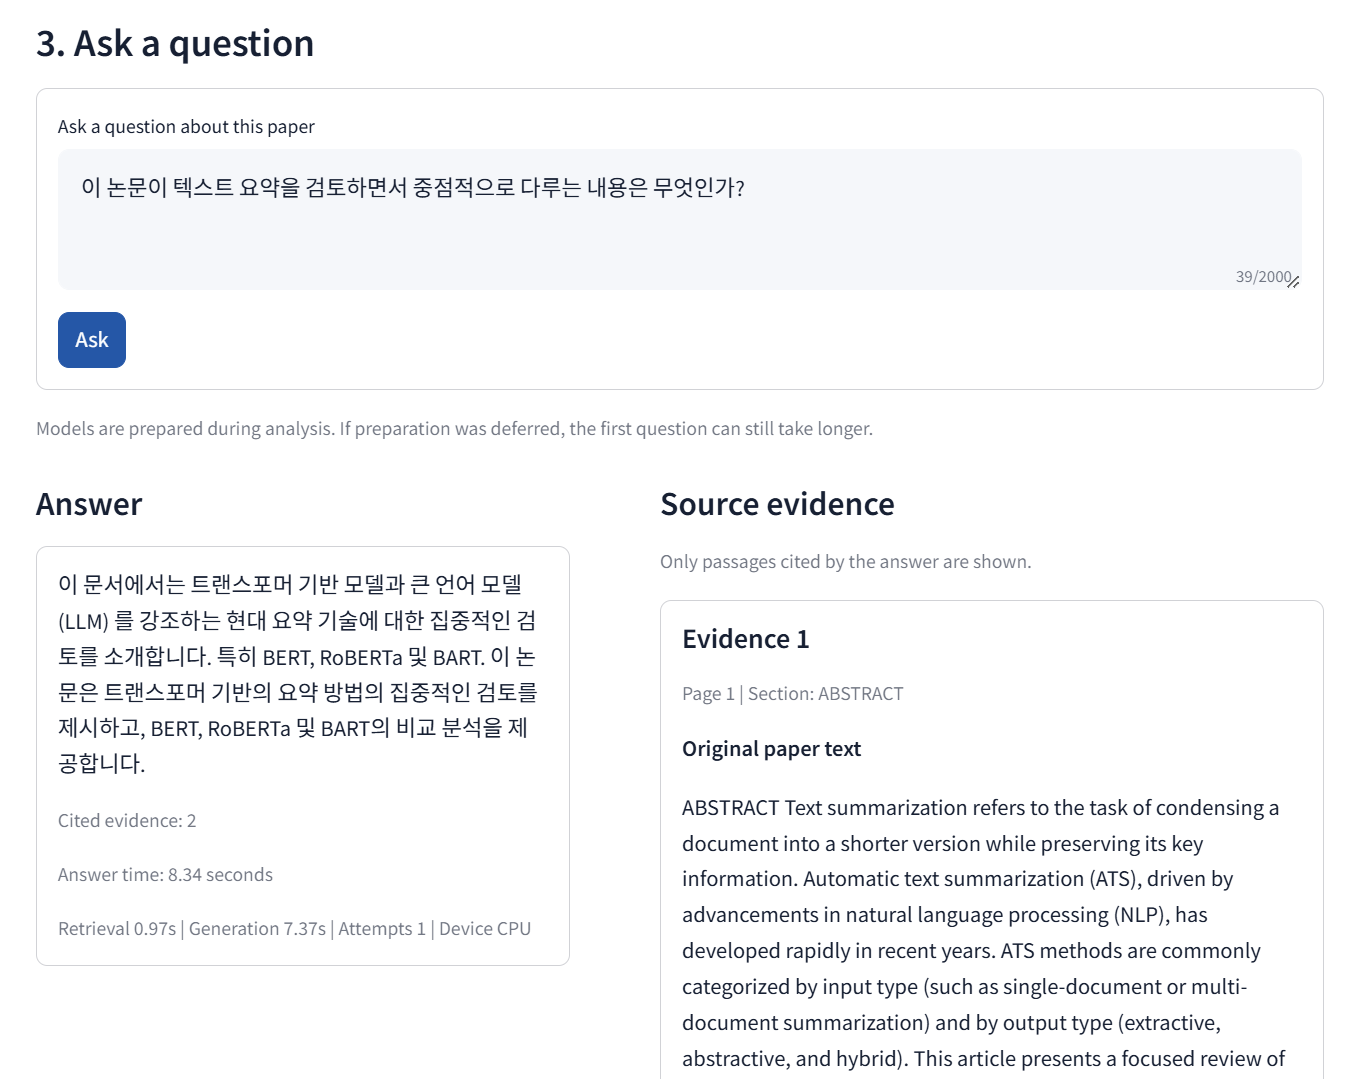
저장소 또는 소스 ZIP을 받은 뒤 Docker Desktop을 준비하고 프로젝트 폴더에서 실행합니다.
docker compose up --build -d질문 화면은 http://127.0.0.1:8501, API 문서는 http://127.0.0.1:8000/docs입니다. 첫 실행에는 고정된 모델을 내려받는 시간이 필요하며 화면은 최대 600초 기다립니다. 텍스트형 영어 PDF 한 편을 업로드한 뒤 답변과 인용, 문장별 원문 대응을 확인할 수 있습니다.
docker compose down종료 후에도 업로드 자료와 모델 캐시는 볼륨에 보관됩니다. Docker 실행 안내에 의존성과 설정을 정리했습니다. 기본 NLLB 번역 모델에는 비상업적 사용 조건이 적용됩니다. 질의응답 서비스는 사용자 컴퓨터에서 실행합니다.
코드와 자료
- GitHub 저장소
- 소스와 평가 자료 ZIP 다운로드
- 최종 결과와 실패 분석
- 논문 30편 평가의 입력과 실제 출력
- 설계 대안의 채택 기준과 중단 판단
- 원문 대조 기능과 실험 기능의 범위
- 별도 환경의 재현 기록
ZIP에는 공개한 소스와 문서, 동결된 평가 자료를 포함합니다. 모델과 비공개 PDF 없이도 Python 3.12에서 저장된 지표와 자료 무결성을 확인할 수 있습니다.
python -m pip install -r requirements-test.txt
python -B scripts/verify_project.py
실제 모델로 결과를 재실행하는 방법과 독립적인 사실 검토 절차는 외부 검증 안내에 있습니다.
소스와 평가 자료 ZIP 다운로드GitHub에서 소스 코드 보기